La fiabilité se mesure face à des fixations enregistrées
Un modèle de saillance est évalué en comparant sa carte aux fixations de personnes qui ont regardé les mêmes images. Le MIT/Tübingen Saliency Benchmark garde ces fixations privées et note chaque modèle soumis sur les mêmes images, le jeu MIT300, avec plusieurs métriques, car aucun chiffre unique ne résume l'accord.
Ces métriques ne sont pas un pourcentage de bonnes réponses. L'AUC vérifie si les points fixés reçoivent des valeurs plus élevées que des points au hasard : un modèle parfait obtient 1, une carte aléatoire environ 0,5. Le NSS lit la valeur de la carte aux fixations, en écarts-types au-dessus de la moyenne. Le CC mesure la corrélation avec une carte de fixations lissée. La divergence KL et le SIM comparent les deux distributions, et l'IG, le gain d'information, se mesure par rapport à un biais central. Chacune répond à une question un peu différente, d'où les sept colonnes du classement.
À consulter : MIT/Tübingen Saliency Benchmark
Ce que le benchmark indique pour UNISAL
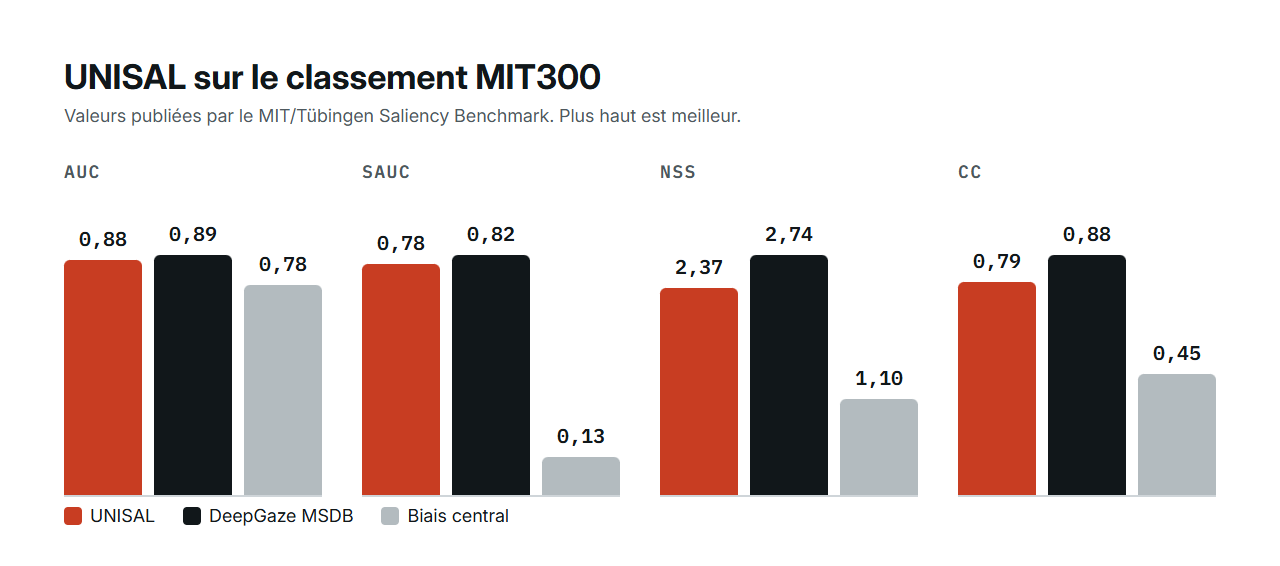
Heatpoints utilise UNISAL, publié à ECCV 2020. Le tableau reprend les lignes du classement MIT300 pour UNISAL, pour le meilleur modèle listé, DeepGaze MSDB, et pour le biais central, qui suppose simplement qu'on regarde au milieu de chaque image.
Lues ensemble, ces trois lignes disent quelque chose d'utile : UNISAL est nettement au-dessus du biais central sur toutes les métriques, et en dessous du plus gros modèle de recherche sur toutes. Il y parvient avec un fichier de poids de 15,4 Mo, ce qui lui permet de répondre en quelques secondes sur un processeur ordinaire plutôt que sur un serveur de recherche.
| Modèle | AUC | sAUC | NSS | CC | KL | SIM | IG |
|---|---|---|---|---|---|---|---|
| UNISAL | 0,877 | 0,784 | 2,37 | 0,785 | 0,415 | 0,675 | 0,951 |
| DeepGaze MSDB, meilleur listé | 0,894 | 0,816 | 2,74 | 0,883 | 0,254 | 0,752 | 1,246 |
| Biais central | 0,783 | 0,130 | 1,10 | 0,446 | 0,951 | 0,482 | 0,000 |
À consulter : MIT/Tübingen Saliency Benchmark · UNISAL paper and implementation
Comment lire l'écart
Deux métriques racontent l'essentiel. Sur l'AUC mélangée, qui retire l'avantage de prédire le centre, le biais central s'effondre à 0,13 alors qu'UNISAL garde 0,78 : le modèle trouve les zones saillantes là où elles sont, pas seulement au milieu. Sur le NSS, la valeur de la carte aux vraies fixations, UNISAL est à 2,37 contre 1,10 pour le biais central et 2,74 pour le meilleur modèle. En clair, quand l'œil d'un participant s'est posé quelque part sur une image du benchmark, la carte d'UNISAL y était généralement élevée, et celle du meilleur modèle de recherche encore plus.
L'écart entre UNISAL et DeepGaze MSDB est réel et constant. C'est le prix d'un modèle qui tourne sur un processeur dans l'outil du site, au lieu d'un grand réseau qui exige une carte graphique. Que ce prix compte ou non dépend de ce que tu fais de la carte.
Ce que le benchmark ne mesure pas
Les images du benchmark sont des photographies naturelles regardées librement pendant quelques secondes. Une page web, une publicité ou une miniature est un autre type d'image, et un visiteur qui a une tâche en tête est un autre type de regard. Un score de benchmark dit que le modèle s'accorde bien avec des fixations en observation libre sur des photos. Il ne dit pas comment il se comporte sur ton interface, et aucun benchmark publié ne le dit.
Heatpoints n'a pas publié son propre benchmark sur des pages web. L'étude des 93 captures décrit ce que le modèle produit sur de vrais sites ; ce n'est pas une comparaison avec des données d'eye-tracking. Traite de la même façon le pourcentage de précision de n'importe quel éditeur : demande quelles images, quels observateurs, quelle métrique, et si le chiffre vient d'un benchmark indépendant ou du test maison de l'éditeur.
À consulter : L'étude des 93 captures
Quels poids Heatpoints utilise, et pourquoi ça compte
UNISAL est livré avec des poids entraînés sur SALICON, un grand jeu de données collecté par suivi de souris, et une version affinée sur MIT1003, un jeu plus petit d'enregistrements d'eye-tracking. Heatpoints exécute la version eye-tracking. Les pages longues sont traitées par fenêtres qui se chevauchent au lieu d'être écrasées dans un seul cadre, et la carte est normalisée par percentile pour qu'un pixel très brillant n'aplatisse pas le reste.
Ces choix changent la carte. La même image traitée par les deux configurations donne des superpositions visiblement différentes : les poids de suivi de souris s'étalent davantage sur les zones vides, les poids d'eye-tracking se concentrent sur le texte et les visages. Compare donc des résultats produits par un seul outil et un seul réglage, et ne mets jamais côte à côte le score d'un outil et celui d'un autre.
À consulter : Comment Heatpoints traite une image
Ce que valent les scores affichés dans l'outil
L'outil d'image affiche un score d'attention, l'intensité moyenne de la carte normalisée ramenée sur 100. Championship ajoute le focus, la dispersion des intensités, la hiérarchie, le contraste entre la cellule la plus forte et la deuxième d'une grille trois par trois, et la couverture, la part des pixels au-dessus d'un seuil. Aucune de ces valeurs n'est une métrique de benchmark, et aucune n'est calibrée sur des fixations. Elles résument une carte pour que deux cartes puissent être comparées.
Un exemple concret sur ce site : sur une fiche produit fictive, recolorer le bouton d'achat a fait passer le score composite de 25 à 24 et la hiérarchie de 6 à 3. La carte elle-même n'a presque pas bougé. Les métriques ont fait leur travail : montrer qu'une modification n'a rien changé, sans avoir à comparer deux superpositions à l'œil.
À consulter : L'expérience sur la fiche produit · Définition des métriques
Se servir d'un score qu'on ne peut pas prendre pour argent comptant
Utilise la carte pour ce qu'un benchmark soutient : repérer les zones susceptibles de ressortir et vérifier que ton point fort voulu en fait partie. Compare une révision à son original avec les mêmes réglages, et lis où l'accent s'est déplacé avant de lire le score. Puis montre la version retenue à de vraies personnes, car un accord avec des fixations sur des photos ne prouve rien sur la compréhension ni sur les clics de ta page.
- Écris ce qui doit ressortir avant de lancer l'image.
- Lis les zones les plus fortes et nomme les éléments dessous.
- Change une seule chose, relance avec les mêmes réglages, compare.
- Prends un écart de score comme une invitation à regarder les deux cartes, pas comme un résultat.
- Valide la version retenue avec de vraies personnes ou un test en ligne.