Une prédiction, pas une mesure
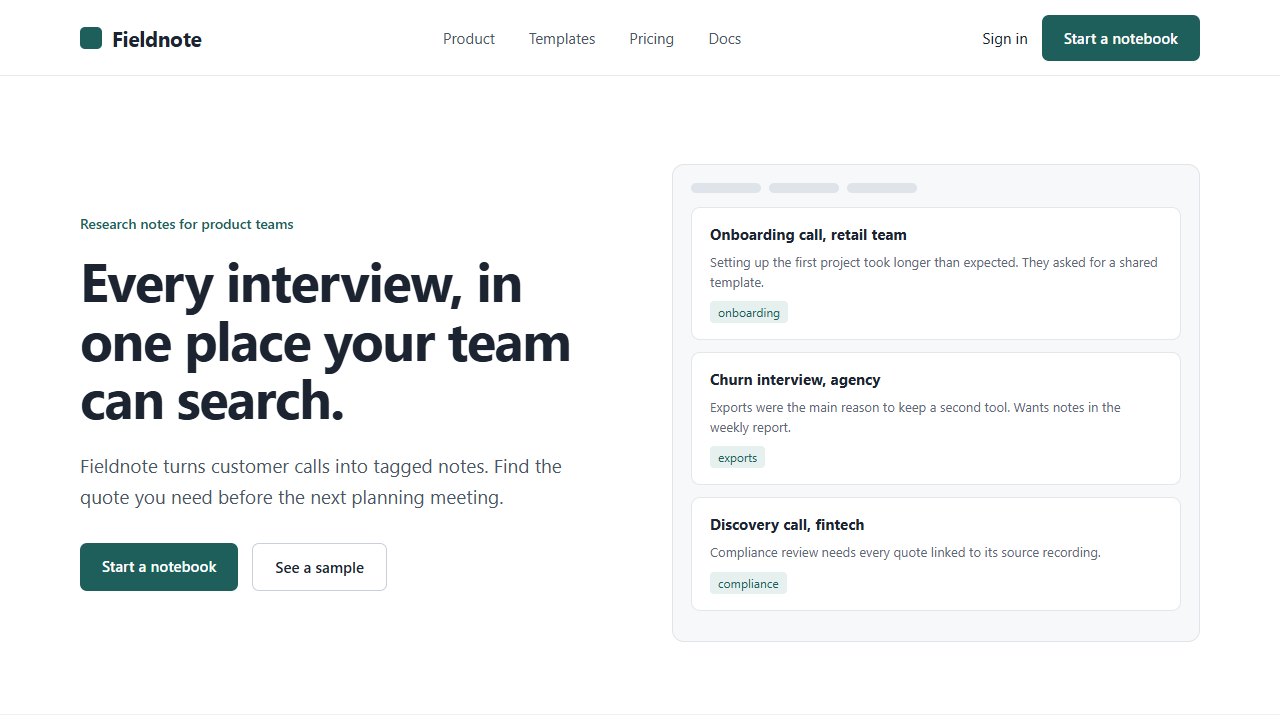
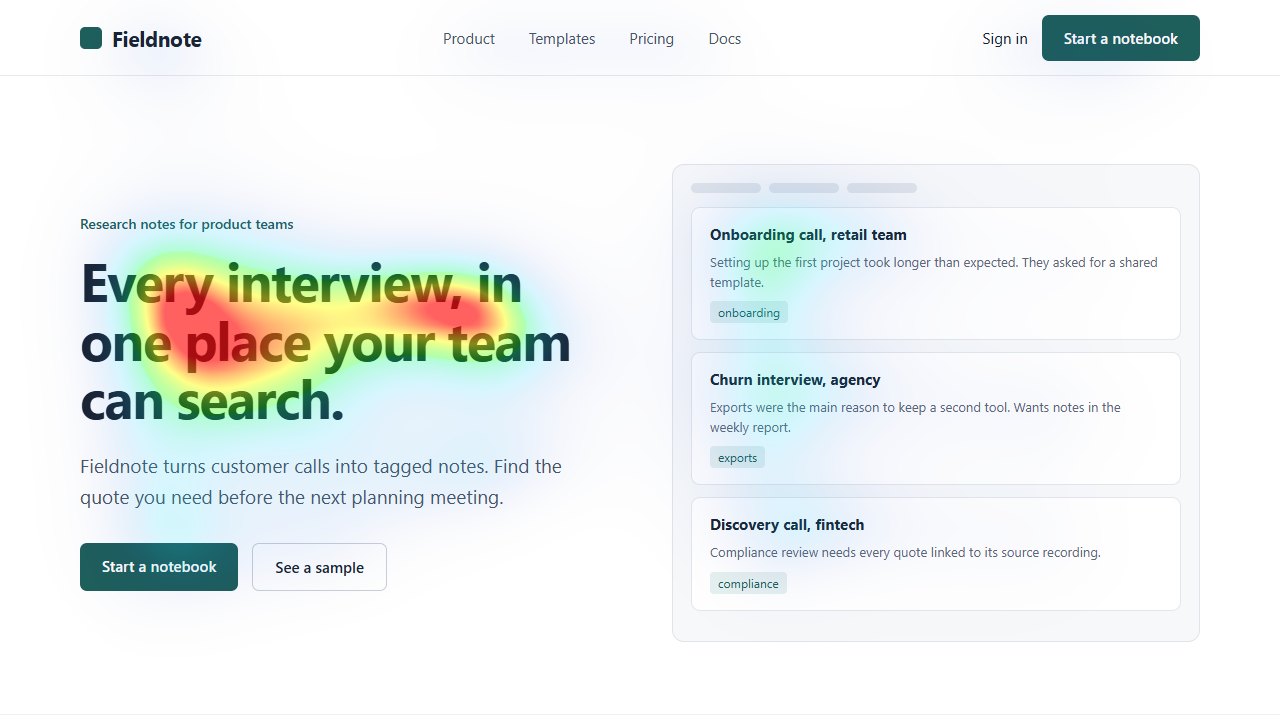
Une carte de saillance attribue une valeur à chaque point d’une image. Les valeurs élevées signalent les zones qu’un modèle juge susceptibles de ressortir et d’attirer le regard lors d’une observation libre. Superposée à l’image en couleurs, elle devient la heatmap d’attention que tu connais.
Personne n’a cliqué, défilé ou regardé ton fichier pour produire cette carte. C’est une prédiction calculée à partir des pixels. Cette différence détermine les questions auxquelles elle peut répondre.
D’où vient l’idée
Les premiers modèles combinaient des contrastes simples de couleur, d’intensité et d’orientation en une seule carte. Le modèle d’Itti, Koch et Niebur publié en 1998 en est un exemple souvent cité : une zone très différente de son voisinage reçoit une valeur élevée.
Les modèles récents apprennent cette correspondance à partir de grandes collections de données d’eye-tracking et d’attention. UNISAL, le modèle utilisé par Heatpoints, est un réseau léger conçu pour prédire la saillance des images et des vidéos. Ses auteurs présentent des résultats sur des jeux de référence comme SALICON et MIT300.
À consulter : Itti, Koch & Niebur (1998), IEEE TPAMI · UNISAL paper and implementation
Comment on évalue un modèle
Les chercheurs comparent les cartes prédites aux fixations enregistrées chez des participants qui ont regardé les mêmes images. Des benchmarks publics comme le MIT/Tübingen Saliency Benchmark gardent ces fixations de côté et notent les modèles avec plusieurs métriques, car aucun chiffre unique ne résume l’accord.
Un bon score signifie que le modèle s’accorde plutôt bien avec des fixations en observation libre sur ce type d’images. Il ne garantit pas le même accord sur ton interface, ton public ou une tâche précise comme comparer des prix.
À consulter : MIT/Tübingen Saliency Benchmark
À quoi elle sert vraiment
Elle aide à relire une hiérarchie visuelle avant publication. Elle peut suggérer qu’une illustration décorative concurrence le titre, ou que le sujet d’une miniature se perd dans un fond chargé. Ce sont des observations que tu peux vérifier en revenant à l’image d’origine.
Elle est aussi reproductible. La même image et les mêmes réglages donnent la même carte, ce qui permet de comparer une révision contrôlée avec l’original.
- Écris quel élément doit porter le message.
- Génère la carte et nomme les éléments sous les zones les plus fortes.
- Modifie une seule chose, comme la taille, le contraste ou le cadrage.
- Compare les deux cartes et garde l’observation, pas un verdict.
Ce qu’elle ne dit pas
La carte ne comprend pas le sens de tes mots, la crédibilité de l’offre ni l’intention du visiteur. Elle ne donne ni ordre de lecture ni durée. Ses couleurs sont relatives à une seule image : ce n’est pas un pourcentage de personnes.
Quand la décision dépend d’un comportement, comme un clic, une inscription ou une durée de visionnage, il faut des données comportementales. La carte aide à choisir les variantes qui méritent d’être montrées ; c’est le public qui tranche.
À consulter : Comment Heatpoints calcule ses métriques